2026년 10월 5일, 같은 날 나온 두 소식이 묘하게 엇갈렸습니다. 하나는 정부가 소버린 AI 확보를 위해 내년 4조7000억원 규모의 프런티어 AI 개발에 나선다는 발표였습니다. 다른 하나는 공무원이 쓰는 정부 AI 플랫폼에 외산 모델이 과반이라는 보도였습니다.
“우리 AI를 만들자”는 큰 그림과 “당장 쓰는 AI는 외산”이라는 현실이 한날 드러난 셈입니다. 이 글은 두 소식을 나란히 놓고, 소버린 AI가 무엇인지부터 차근차근 풀어 봅니다.
소버린 AI란 무엇인가: ‘국산’보다 ‘통제권’
소버린 AI(Sovereign AI)는 말 그대로 ‘주권 AI’입니다. 한 나라가 AI 모델과 데이터, 연산 자원을 스스로 통제할 수 있는 상태를 뜻합니다. 해외 기업이 서비스를 끊거나 가격을 올려도 버틸 수 있느냐가 핵심입니다.
그래서 소버린 AI는 단순한 국산품 장려와 다릅니다. 데이터를 어디에 두는지, 연산을 어디서 하는지, 문제가 생기면 누가 책임지는지가 함께 따라붙습니다. 모델 이름에 태극기가 붙었다고 끝나는 문제가 아니라는 뜻입니다.
독자 AI 파운데이션 모델 사업, 지금까지의 경과
정부의 대표적인 소버린 AI 정책이 ‘독자 AI 파운데이션 모델’, 줄여서 독파모입니다. 2025년 8월 정예팀 5곳을 뽑아 시작했습니다. 이후 단계마다 평가로 팀을 줄여 가는 방식입니다.
2026년 1월 15일 1차 평가에서 네이버클라우드와 NC AI가 떨어졌습니다. 네이버클라우드는 제출 모델 일부에 알리바바 ‘큐웬’의 비전 인코더를 쓴 점이 기술 자립 기준에 걸렸습니다. 이어 추가 선발로 모티프테크놀로지스가 합류했습니다.
2026년 8월 18일 발표된 2차 평가에서는 4팀 중 모티프가 탈락했습니다. 이제 SK텔레콤, 업스테이지, LG AI연구원 3팀이 남았습니다. 아래는 공개된 2차 평가 점수를 정리한 비교표입니다.
| 팀 | 2차 평가 모델 | 종합 점수 | 전문가 평가 | 벤치마크(AAII) | 결과 |
|---|---|---|---|---|---|
| SK텔레콤 | A.X K2 | 70.6점 (1위) | 29.3점 | 35점 | 통과 |
| 업스테이지 | Solar Open2 | 69.9점 (2위) | 29.1점 | 37점 | 통과 |
| LG AI연구원 | K-EXAONE 2.0 | 69.0점 (3위) | 29.5점 (1위) | 31점 | 통과 |
| 모티프테크놀로지스 | Motif 3 | 65.8점 | – | 47점 (1위) | 탈락 |
눈에 띄는 점은 벤치마크 1위였던 모티프가 종합 점수에서 밀렸다는 것입니다. 성능 점수 하나로 승부가 갈리지 않는 구조라는 뜻입니다. 정부는 통과한 3팀의 GPU 지원을 768장 수준에서 1000장 규모로 늘린다고 밝혔습니다.
프런티어 AI 투트랙, 무엇이 달라지나
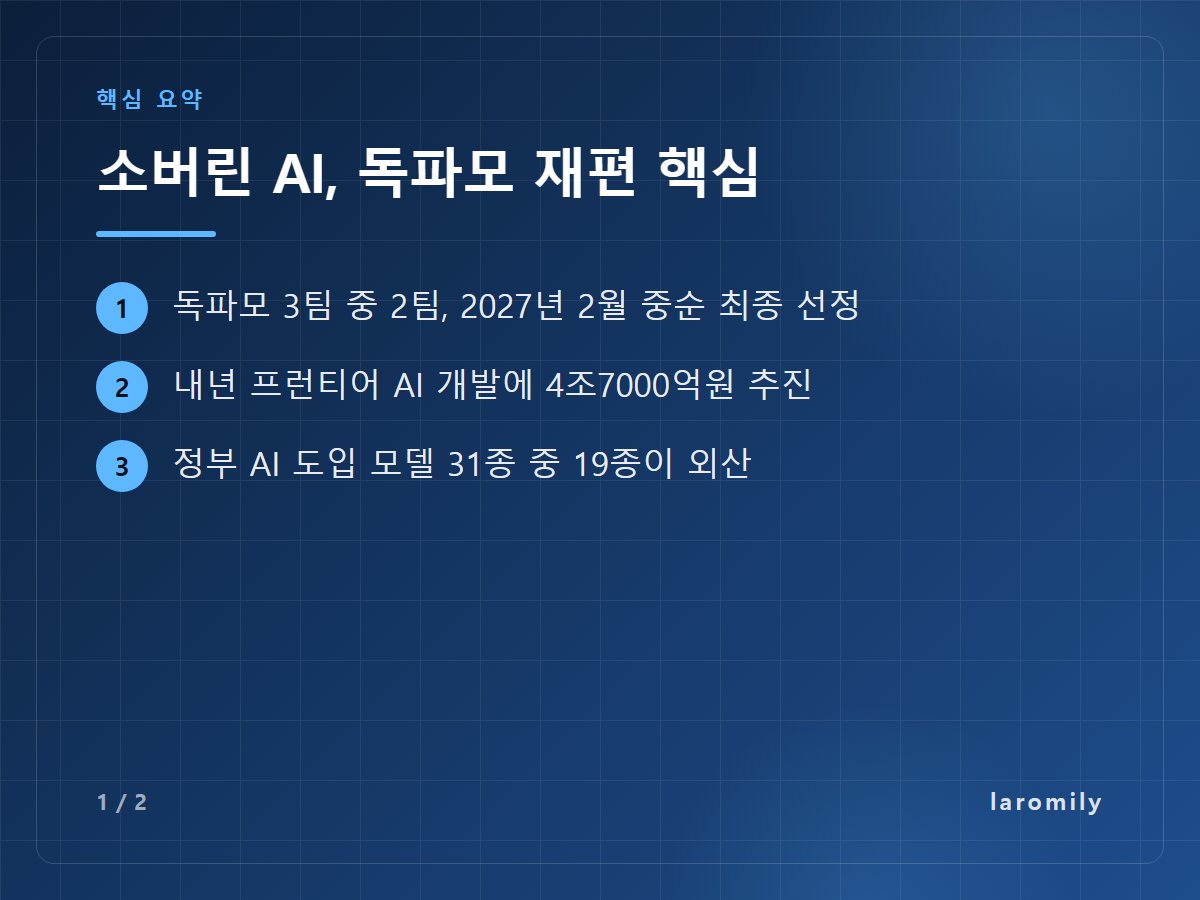
10월 2일 기자간담회에서 류제명 과학기술정보통신부 2차관은 독파모를 두 갈래로 재설계한다고 밝혔습니다. 하나는 세계 최고 수준을 겨냥하는 프런티어 모델 트랙입니다. 다른 하나는 제조·금융·공공 같은 산업 현장 확산 트랙입니다.
배경에는 지난 4월 공개된 앤트로픽의 최상위 모델 ‘미토스’가 있습니다. 류 차관은 미토스 이후 변화를 두고 “과녁을 통째로 들어 올려야” 하는 충격이라고 표현했습니다. AI가 해킹 코드를 스스로 만들 수 있게 되면서 AI가 국가 안보자산이라는 인식도 커졌습니다.
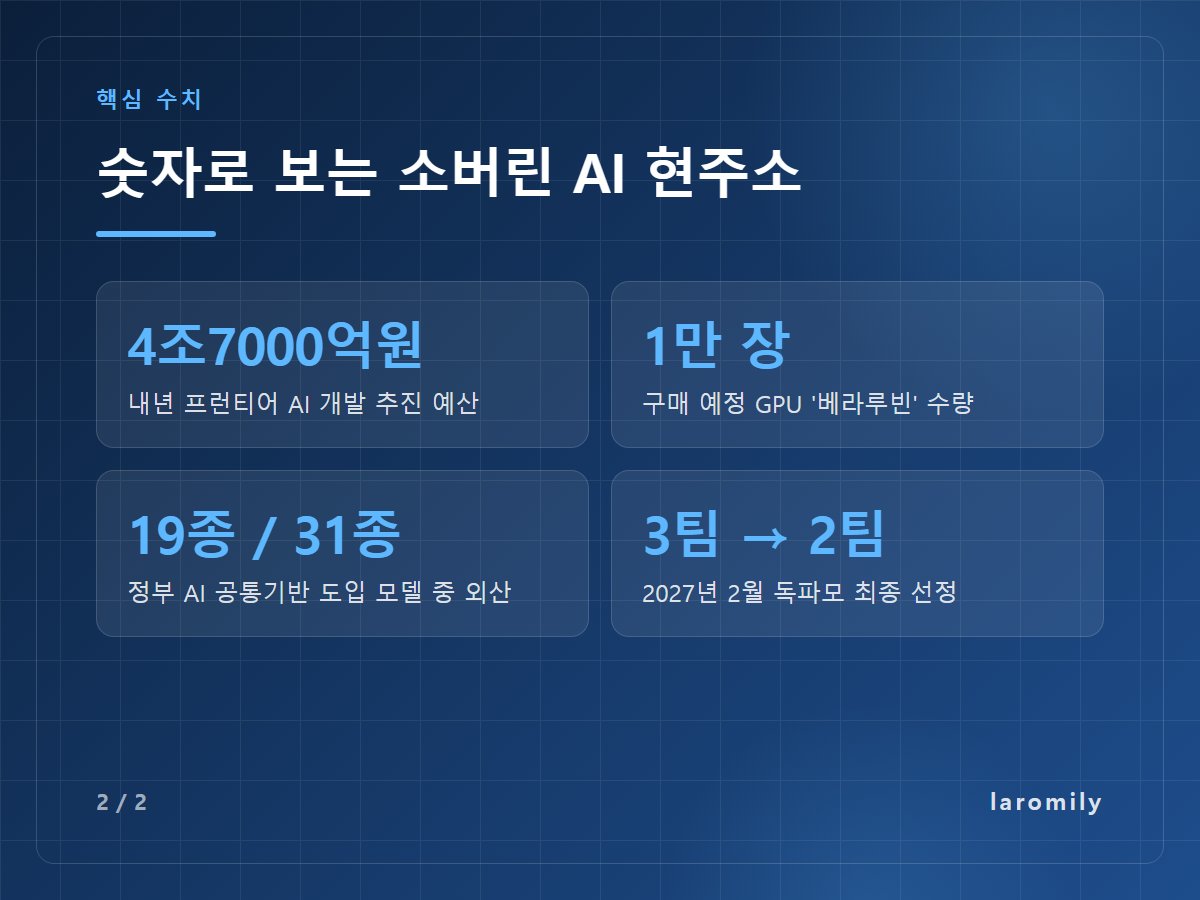
보도된 예산 구성은 이렇습니다. 4조7000억원 가운데 엔비디아 차세대 GPU ‘베라루빈’ 1만 장에 3조9000억원, 학습 데이터에 8000억원이 잡혔습니다. 해외 우수 연구자 20명 유치에도 250억원이 들어갑니다.
일정도 정리해 둡니다. 기존 3팀은 2027년 2월 중순 3차 평가를 거쳐 2팀으로 압축됩니다. 프런티어 사업은 12월 국회 예산 승인을 거친 뒤 공모하고, 내년 2~3월 수행 주체를 정할 계획입니다. 대기업뿐 아니라 스타트업도 참여할 수 있게 설계한다고 했습니다.
📌 함께 읽으면 좋은 글: AI 데이터센터 붐에 걸린 브레이크: 텍사스의 허가 중단과 월가의 의심
소버린 AI 외치는데 공무원 AI는 왜 외산이 과반일까
같은 날 조선일보는 김장겸 의원이 행정안전부·과기정통부에서 받은 자료를 보도했습니다. ‘범정부 초거대 AI 공통기반’에 지난달 기준 도입된 모델 31종 중 국산은 12종, 외산은 19종이었습니다. 이미 탑재된 11종 중에서도 외산이 7종이었습니다.
범정부 AI 공통기반은 중앙부처와 지자체가 AI 모델과 GPU를 함께 쓰는 정부 전용 플랫폼입니다. 삼성SDS와 네이버클라우드의 플랫폼을 바탕으로 만들어졌습니다. 올해 2차 사업에서는 여러 민간 모델을 골라 쓰는 ‘AI 게이트웨이’를 붙이는 계획이 나와 있습니다.
외산 모델이 많은 이유는 짐작할 수 있습니다. 요약·번역·검색 보조 같은 업무마다 잘 맞는 모델이 다르고, 공개된 해외 모델은 선택지가 훨씬 넓습니다. 국산 모델만으로 모든 기능을 채우기는 아직 어렵다는 현실도 있습니다.
논란을 키운 것은 중국 베이징인공지능연구원(BAAI)의 ‘Bge-M3’입니다. 미국 상무부가 수출 통제 대상으로 지정한 기관의 모델입니다. 과기정통부는 이 모델이 글자를 숫자 벡터로 바꾸는 임베딩 모델이고, 보안이 확보된 행정망 안에서만 돈다고 해명했습니다.
비교할 만한 사례도 있습니다. 2026년 7월 공고된 전 국민 대상 ‘모두의 AI’ 사업은 국산 모델을 원칙으로 하고, 외산은 대체할 수 없는 영역에만 최소한으로 쓰게 했습니다. 같은 정부 안에서도 사업마다 기준이 다른 셈입니다.
소버린 AI 논쟁의 쟁점 정리표
두 소식을 겹쳐 보면 쟁점이 몇 가지로 모입니다. 한쪽 주장만 옳다고 보기 어려운 문제라 양쪽 논리를 함께 적었습니다.
| 쟁점 | 국산 우선 쪽 논리 | 현실론 쪽 논리 | 확인된 사실 |
|---|---|---|---|
| 공공 AI의 외산 비중 | 정책과 실행이 따로 논다 | 업무별 최적 모델을 써야 한다 | 도입 31종 중 외산 19종 |
| 중국 모델 사용 | 제재 기관 모델은 배제해야 | 임베딩 모델, 행정망 내부 운영 | BAAI Bge-M3 도입 |
| 프런티어 투자 규모 | 안보 차원의 투자가 필요 | 재원 대비 성과 검증이 필요 | 4조7000억원, 국회 심의 전 |
| 독파모의 위상 | 기술 자립의 기반 | 프런티어 사업과 역할 정리 필요 | 3차 평가 후 2팀 선정 예정 |
개인과 기업에는 어떤 영향이 있을까
개인에게 가장 가까운 변화는 공공 서비스입니다. 민원 안내나 행정 문서 검토에 AI가 쓰이면, 그 AI가 어떤 모델이고 데이터가 어디에 머무는지가 곧 내 정보의 문제가 됩니다. 공공 AI의 모델 목록과 보안 검증 기준이 공개되는지 지켜볼 만합니다.
기업에는 기회와 숙제가 함께 옵니다. 프런티어 사업이 스타트업에도 열리면 새 참여 기회가 생깁니다. 산업 확산 트랙은 제조·금융 현장에 국산 모델을 붙이는 수요를 만들 수 있습니다. 반면 GPU 1만 장 규모가 일부 대형 컨소시엄에 몰릴 수 있다는 점은 변수입니다.
투자자라면 ‘소버린 AI 수혜’라는 말만 보고 판단하지 않는 것이 좋습니다. 예산은 아직 국회 심의 전이고, 독파모 최종 2팀도 2027년 2월에야 정해집니다.
📌 함께 읽으면 좋은 글: 오픈AI GPT-6 솔·루나 공개, 두 모델 차이와 ‘가격은 반값’이 뜻하는 것
소버린 AI의 성패는 ‘만드는 AI’와 ‘쓰는 AI’의 기준을 맞추는 데 달렸다
정부는 프런티어 모델에 큰돈을 걸고, 독파모는 산업 현장으로 넓히겠다고 합니다. 방향 자체는 AI를 안보자산으로 보는 세계 흐름과 맞닿아 있습니다.
다만 소버린 AI는 만드는 것만큼 쓰는 것이 중요합니다. 정부 스스로 쓰는 AI에서 외산 과반과 제재 기관 모델 논란이 나온다면 기준부터 다시 세워야 합니다. 12월 예산 심의와 2027년 2월 독파모 최종 선정이 그 기준을 확인할 다음 시험대입니다.
참고 자료
- 국가대표 AI ‘투트랙’ 재편…프런티어 AI에 4.7조 출자 추진 – 서울신문 (2026-10-05)
- 정부 “내년 ‘프론티어AI 개발’ 4조7000억원 투입…독파모 ‘투트랙’으로” – 아시아경제 (2026-10-05)
- [류제명 2차관 “독파모 계속될 것⋯프론티어AI도 새롭게 추진” [일문일답] – 아이뉴스24](https://m.inews24.com/v/2011570)
- 독파모, 내년부터 ‘프런티어 AI·산업 확산’ 투트랙 개편 – 뉴스1
- “소버린 AI 한다더니” 공무원용 AI에 외산 모델 과반수 – 조선일보 (다음 뉴스, 2026-10-05)
- 독파모 2차 평가, 업스테이지·SKT·LG AI연구원 통과 – 전자신문 (2026-08-18)
- 과기부, 독파모 2차 평가 세부점수 공개 – 이데일리
- 네이버, ‘국가대표 AI’ 도전 포기 – 뉴시스 (2026-01-15)
- 범정부 AI 공통기반, 챗봇 넘어 에이전트로 – ZDNet Korea (2026-08-10)
- ‘모두의 AI’ 국산 모델이 원칙·외산은 필요 최소로 – 전자신문 (2026-07-21)
- 한국형 ‘독자 AI 파운데이션 모델’ 만들자…’소버린 AI’ 시동 – 경향신문 (2025-08)